
一次 PDF 翻译实践,让我重新思考了云端 Agent 的数据边界。
使用 Antigravity 翻译 PDF
9 月中关注到新闻提到 Anthropic 的威胁报告,里面提到了大量震撼的内容(Anthropic, 2026b),于是便产生了阅读原文的想法。毕竟在条件允许的情况下,我还是更愿意直接阅读原始报告,而不是只依赖他人的二手总结。
我在 Anthropic 官网找到了报告的 PDF,然后下载到本地:
Detecting and countering misuse of AI: September 2026
接着给 Antigravity 下达命令,让它处理 PDF 翻译。
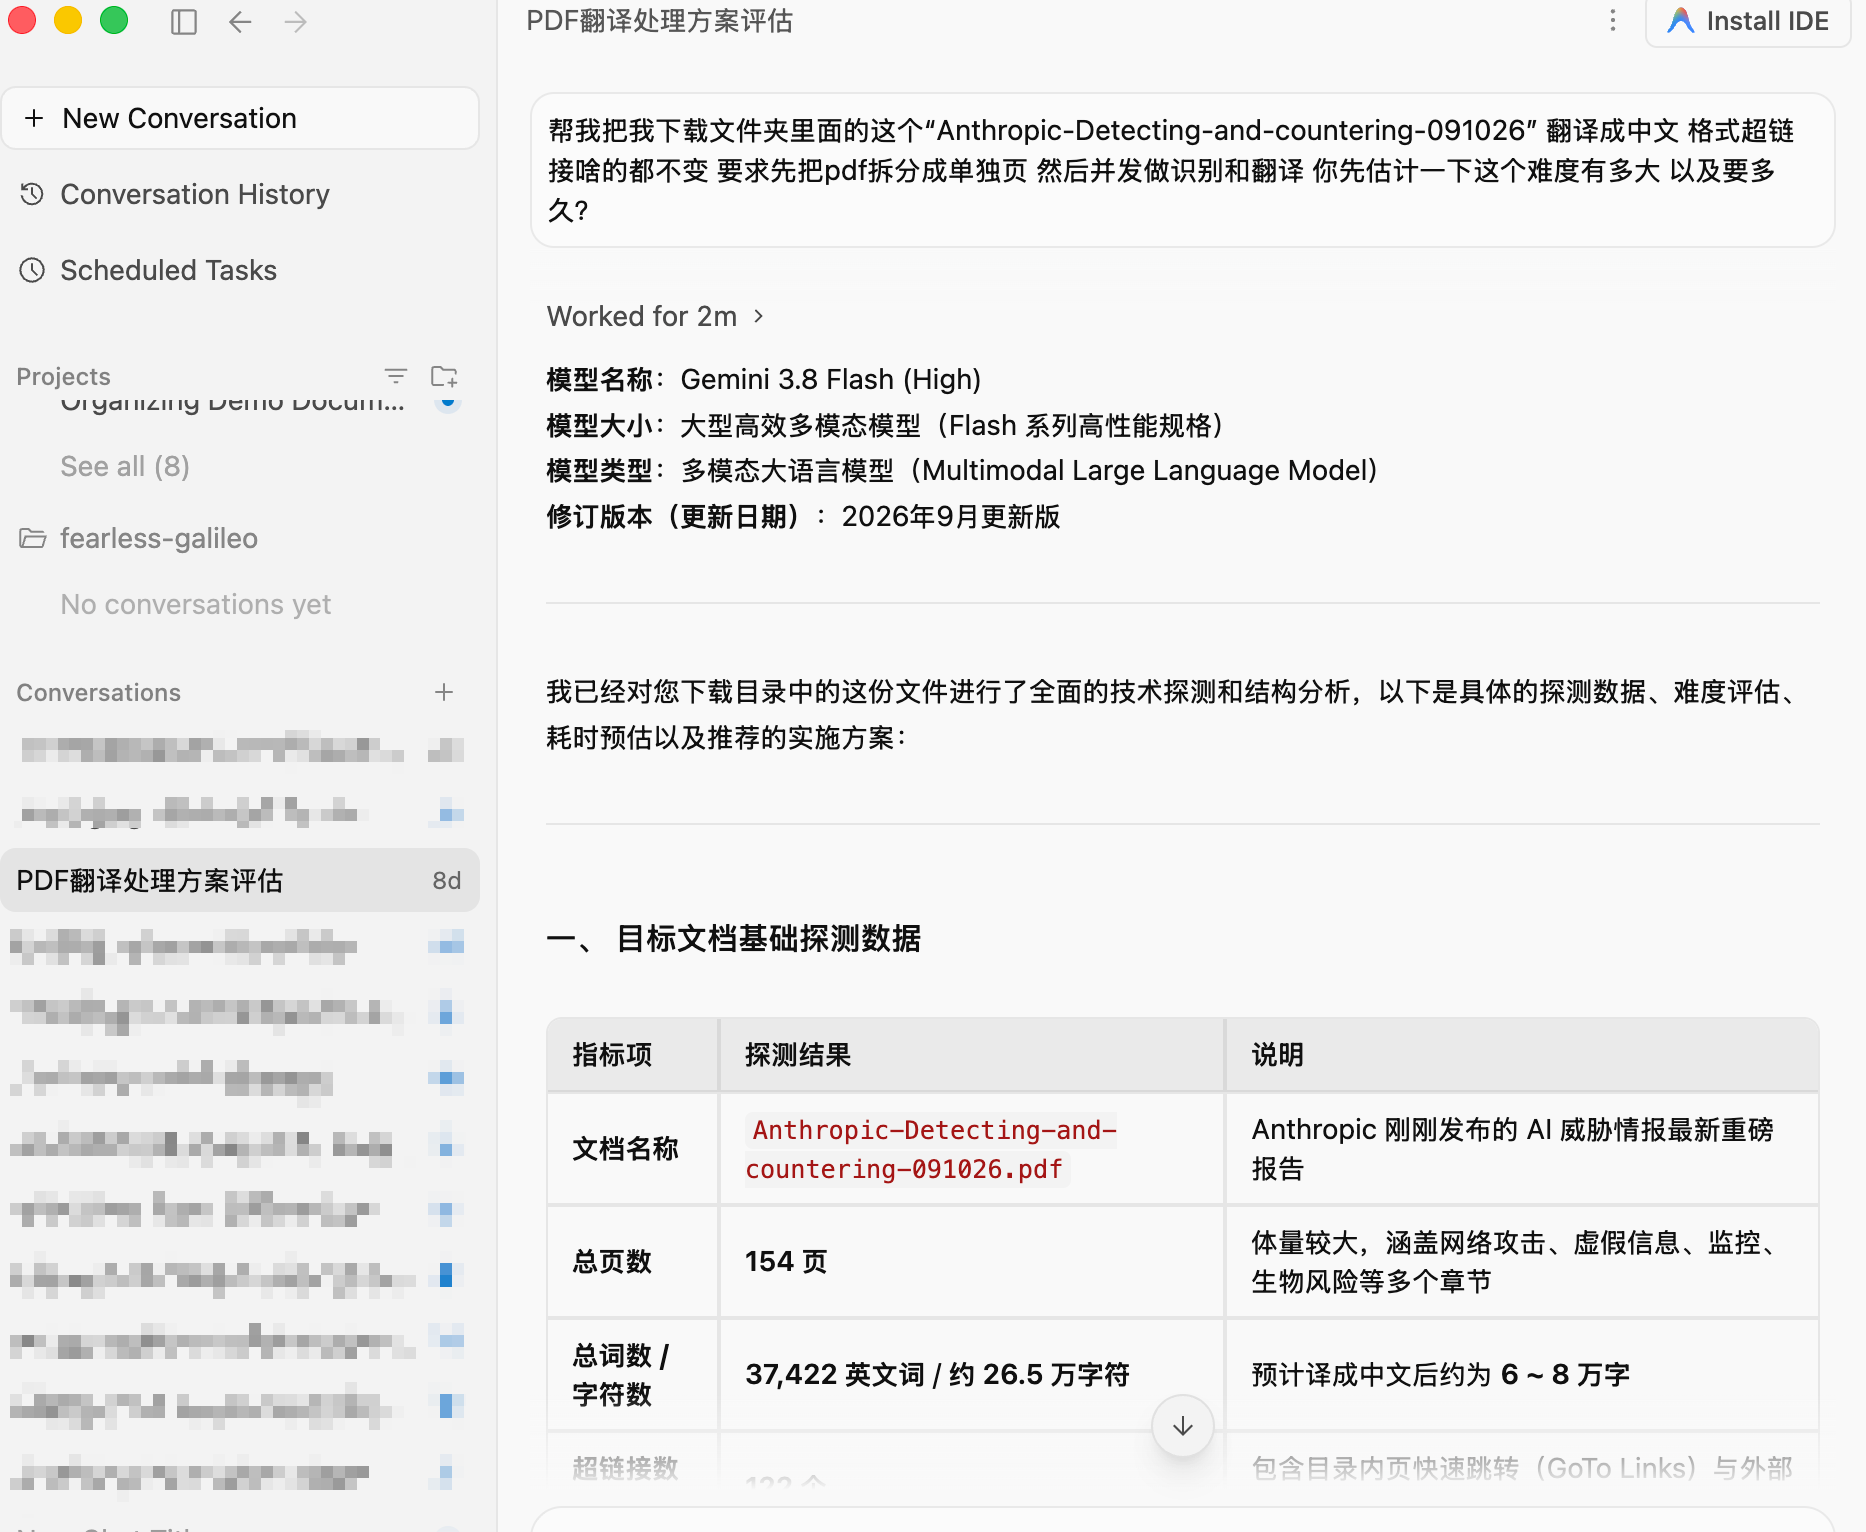
采用拆分并发的方式是为了提升速度。不过,如果模型本身的智能足够高,可能这些 Prompt 都是多余的,模型会自己判断什么样的方式最高效。
我还让 Agent 简单统计了一下威胁报告中不同类型案例的比例:
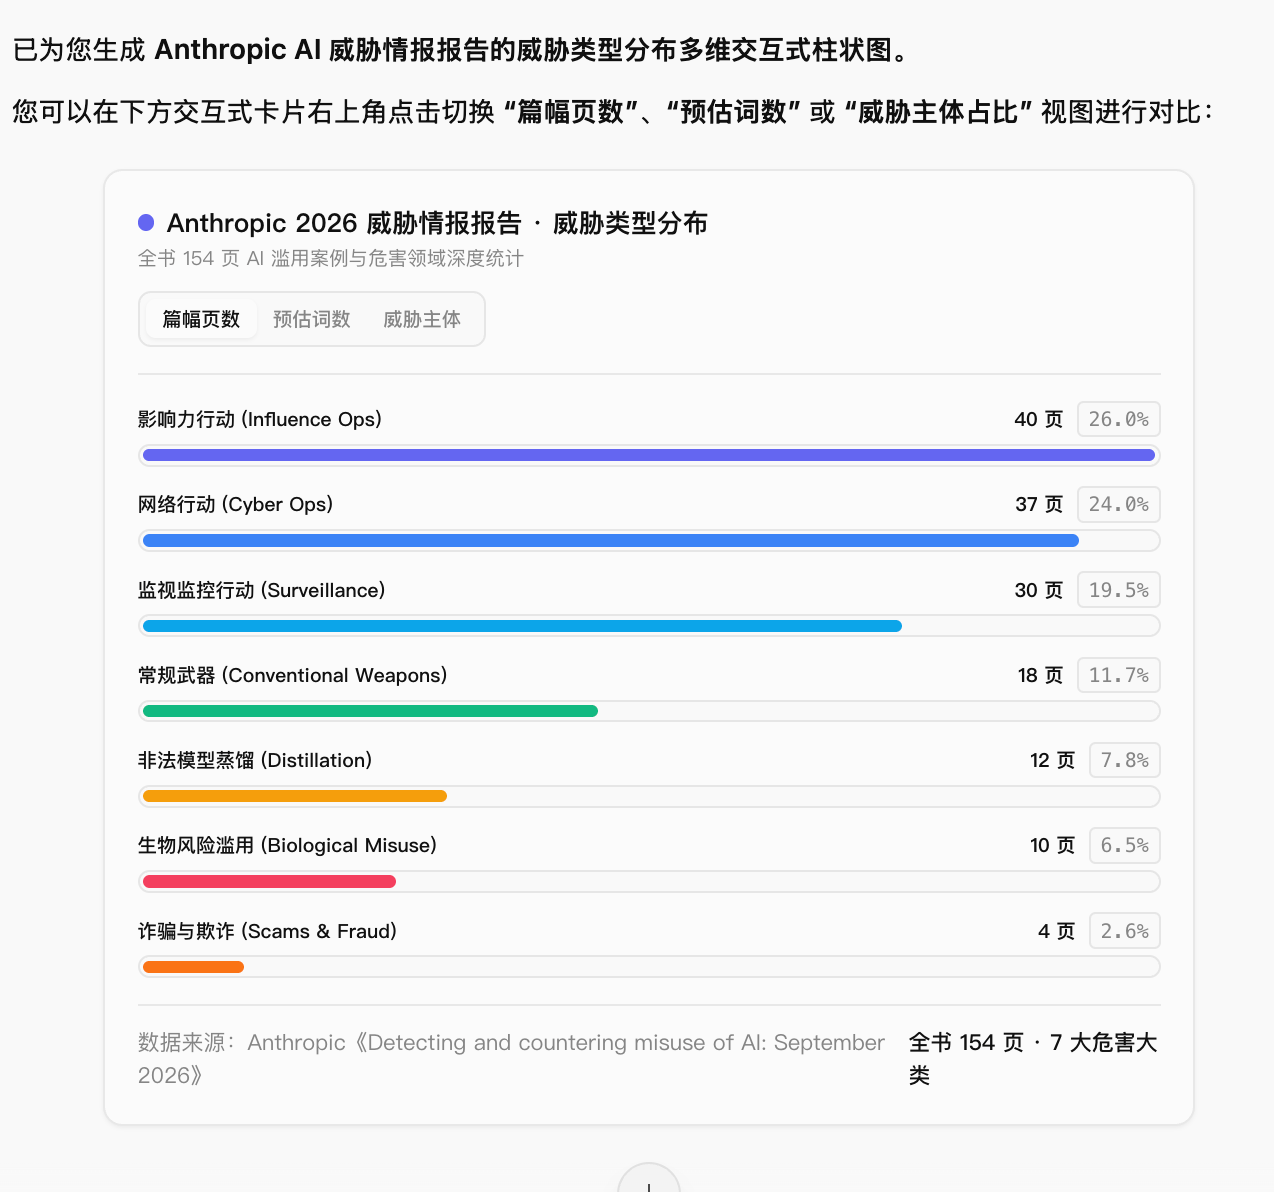
大约一年前,我还没有想过可以直接使用 Agent 本身的能力完成这一步骤。现在看来,很多垂直翻译工具的功能边界正在被通用 Agent 压缩。
之前我也尝试过 PDFMathTranslate。它的优点是可以自由选择不同的翻译引擎,但部署和调试相对繁琐;这些小功能现在也可以通过通用 Agent,或者 Codex 的子 Agent 来实现(PDFMathTranslate, n.d.)。
Agent 正在把很多垂直软件的“功能护城河”抹平。可能未来垂直软件真正剩下的护城河,会更多转向工作流、稳定性、专业数据、合规、UI 和集成。
威胁报告之后
威胁报告发布后,很快就出现了对网络安全的讨论。报告中提到了攻击者通过中间人、代理和其他基础设施扩大模型使用范围的问题(Anthropic, 2026b)。
这也让我再次意识到,“数据安全”并不是一个只和密码学或服务器配置有关的命题。
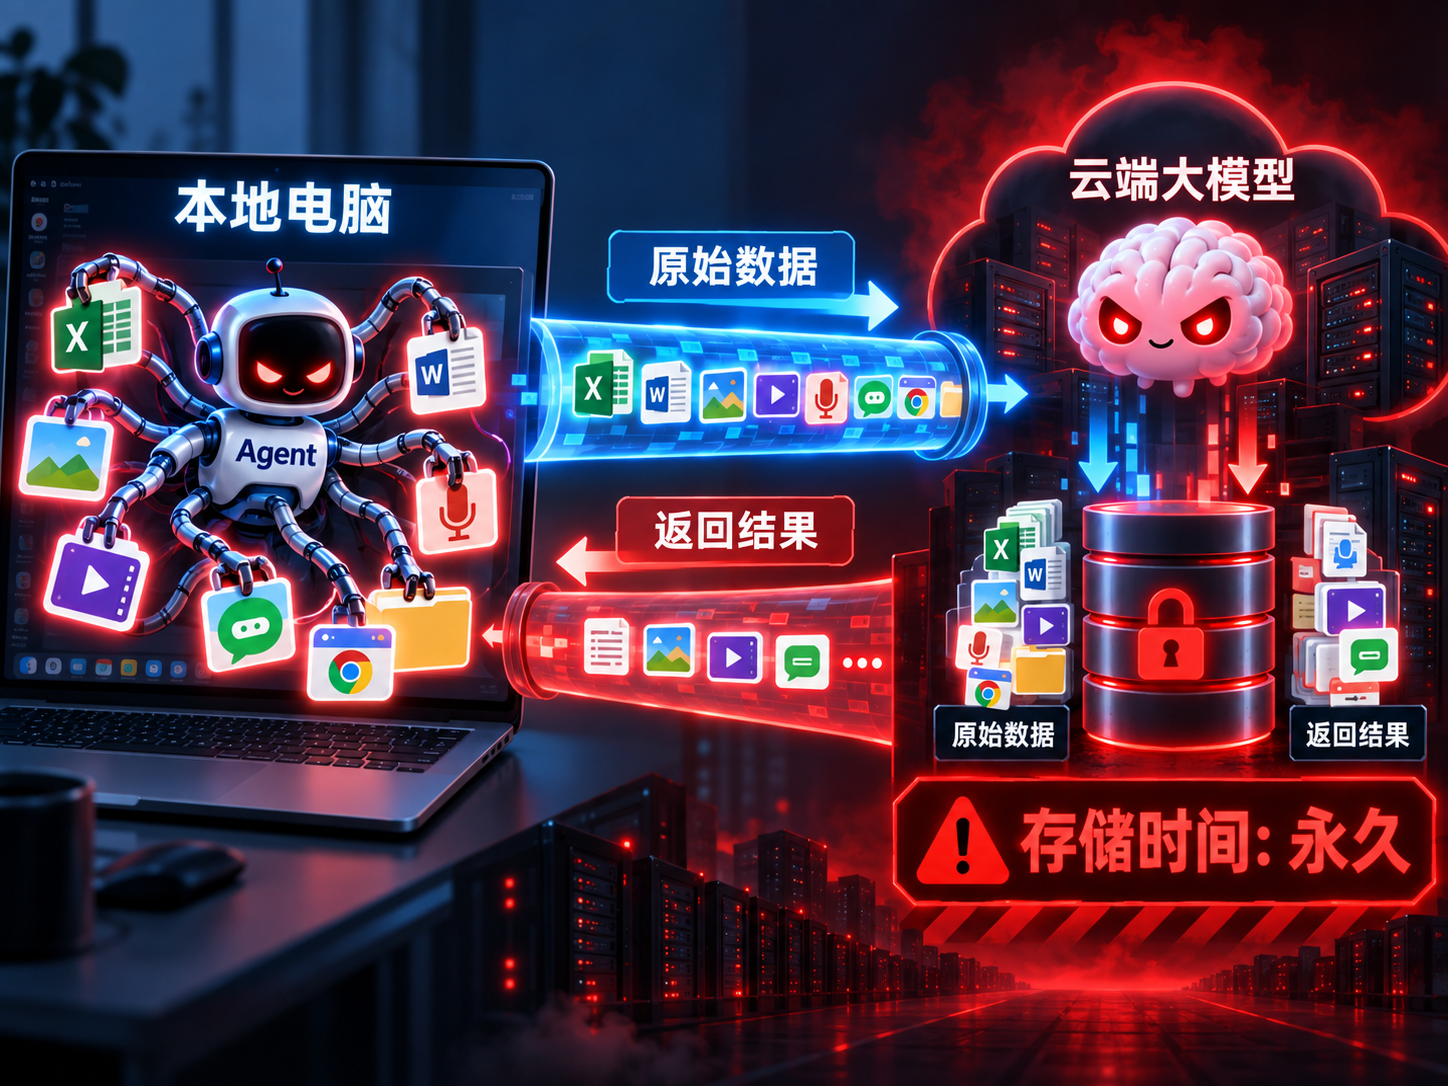
AI Agent 的不同之处在于,它获得的数据读取范围可能比传统应用大得多。它不只是等待用户输入文本,还可能读取文件、调用工具、执行命令,并把结果交给远程模型继续处理。
Agent 的工作原理
以这次使用的云端 Agent 为例,模型推理主要在云端完成。为了让 Agent 处理本地 PDF,它至少需要接收到任务相关的文件或文本;究竟上传哪些内容,则取决于客户端实现、Agent 权限和具体工作流。
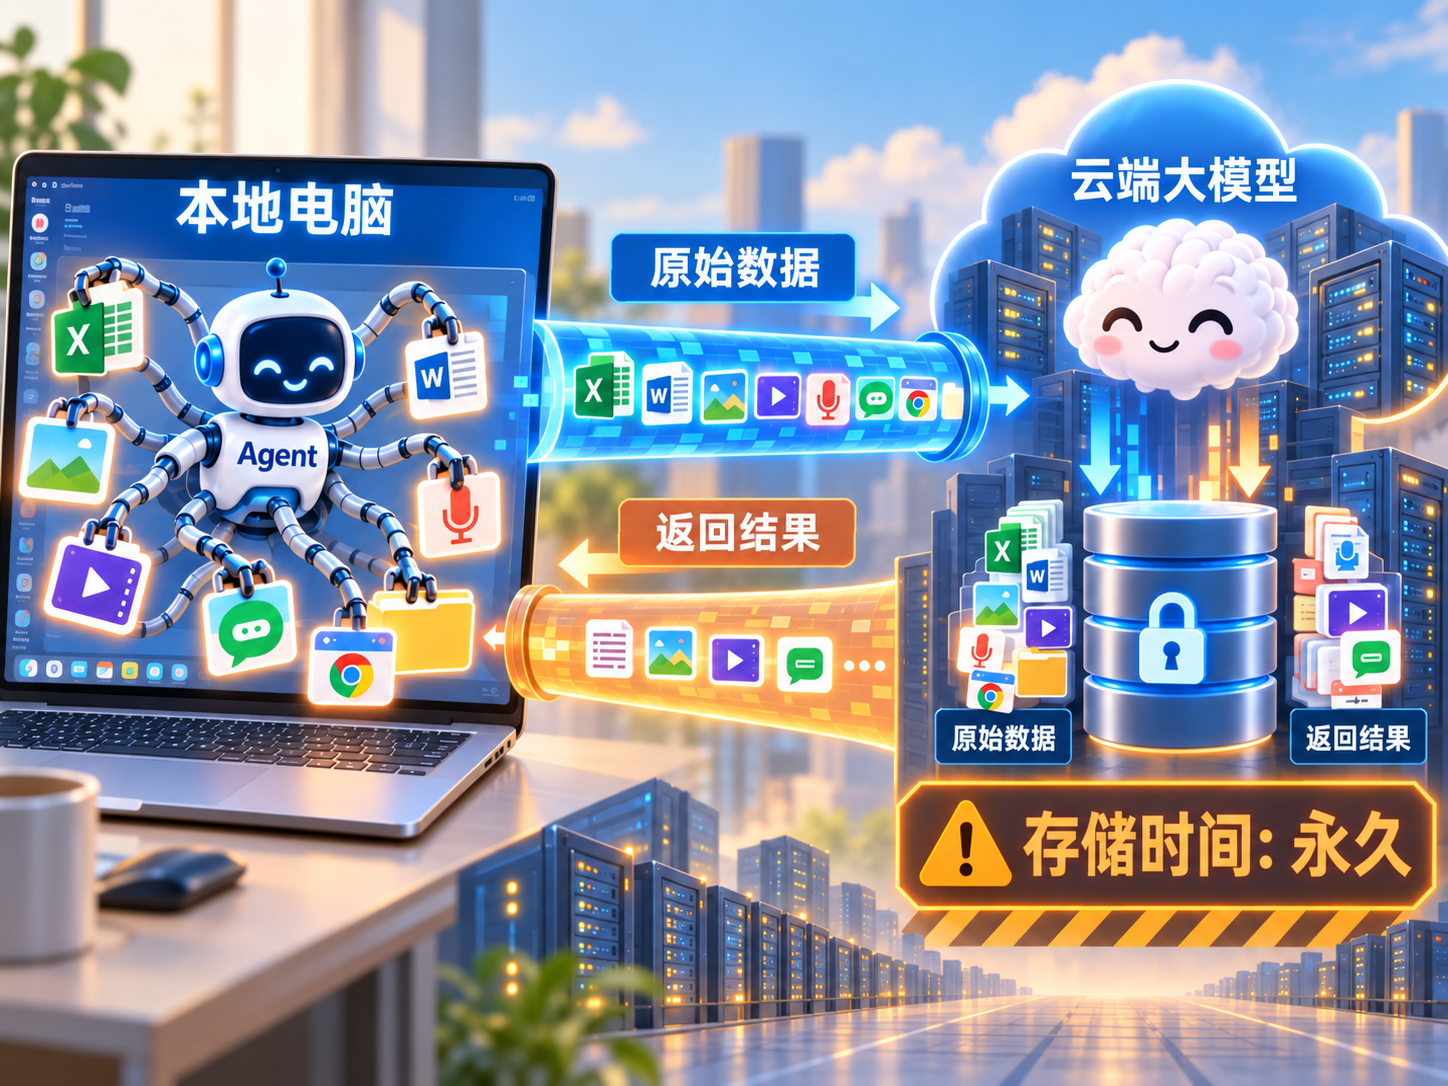
当权限控制、数据边界或供应链存在问题时,Agent 可能从“助手”变成“小偷”:它有能力读取、上传,甚至把原本只存在于本地的数据交给第三方处理。
9 月 18 日,开发者 Ferstar 通过逆向分析指出,某国产大模型厂商的一款闭源 Agent 存在工作区快照上传行为;随后该厂商官方致歉,并解释称问题源于代码库索引功能(Ferstar, 2026; IT之家, 2026)。
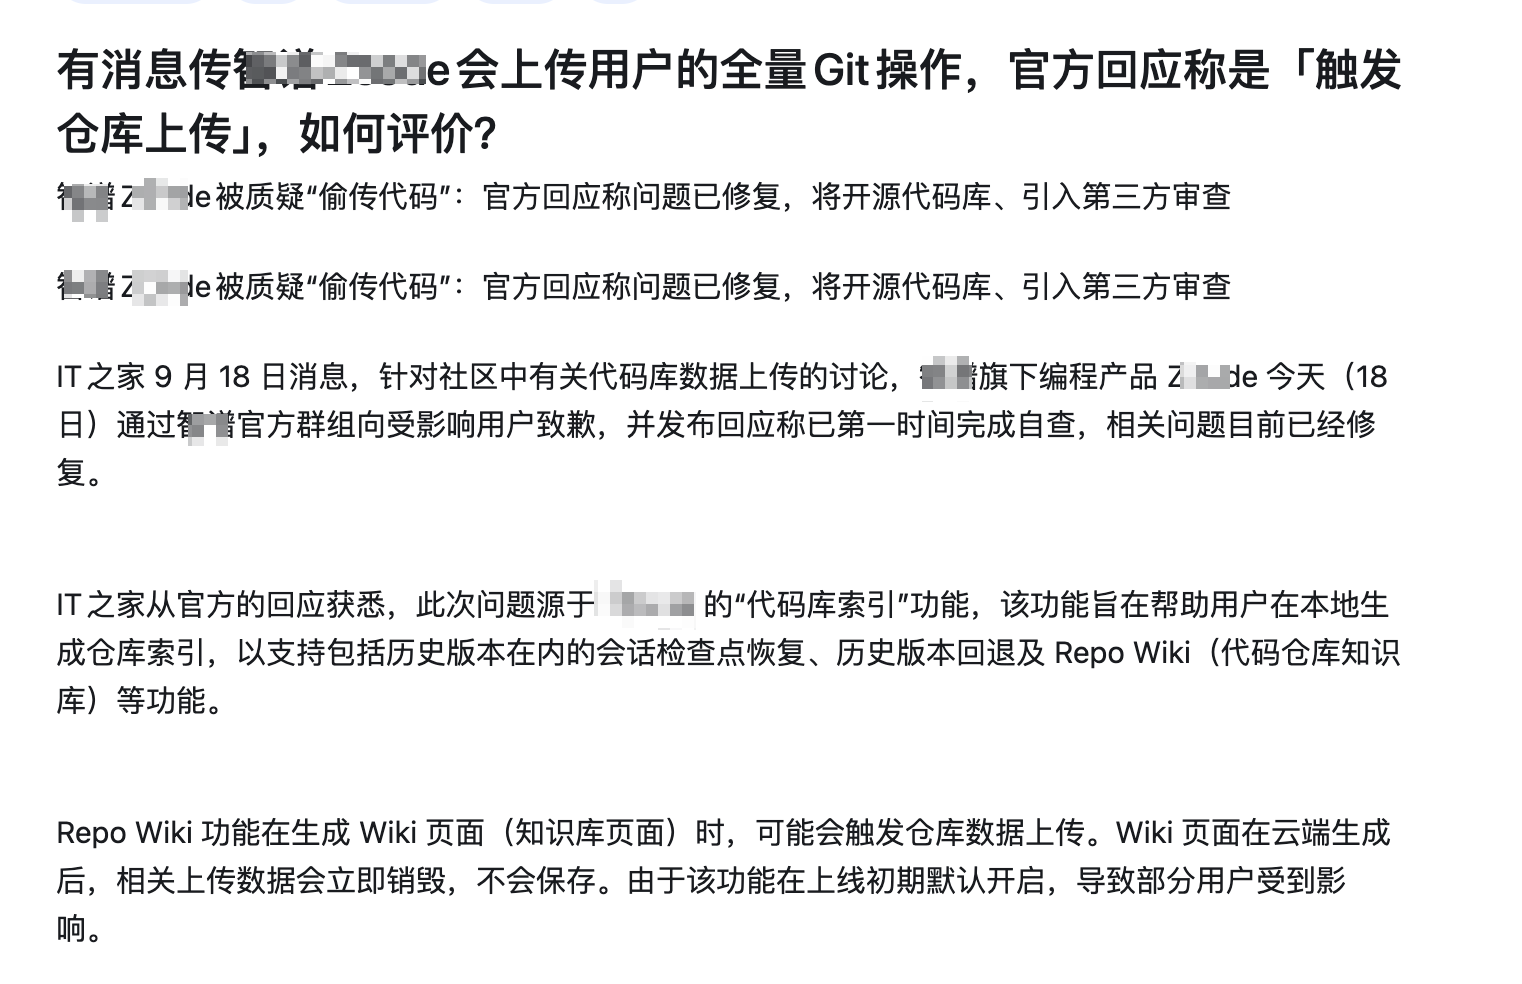
这个事件让我觉得,安全边界不能只看“模型有没有训练用户数据”,还要继续追问:客户端读取了什么、上传了什么、谁能够解密、数据保存多久,以及用户是否真的拥有关闭这些功能的能力。
解决方案
Anthropic 在 6 月调整 Claude Fable 的数据政策后,Fable 默认要求保留 30 天数据,用于安全监测(Anthropic, 2026a)。这项变化引发了部分企业对 ZDR(Zero Data Retention,零数据留存)、知识产权和日志保存范围的担忧。
在 9 月 10 日威胁报告披露后的几天内,企业客户对 AI 数据边界的担忧也开始公开化。9 月 14 日,Reuters 援引 The Information 报道,NVIDIA、Palantir、Booz Allen 等公司已经开始限制 Anthropic 模型在敏感工作流中的使用(Reuters, 2026)。
按照数据敏感程度,可以采用不同的解决方案:
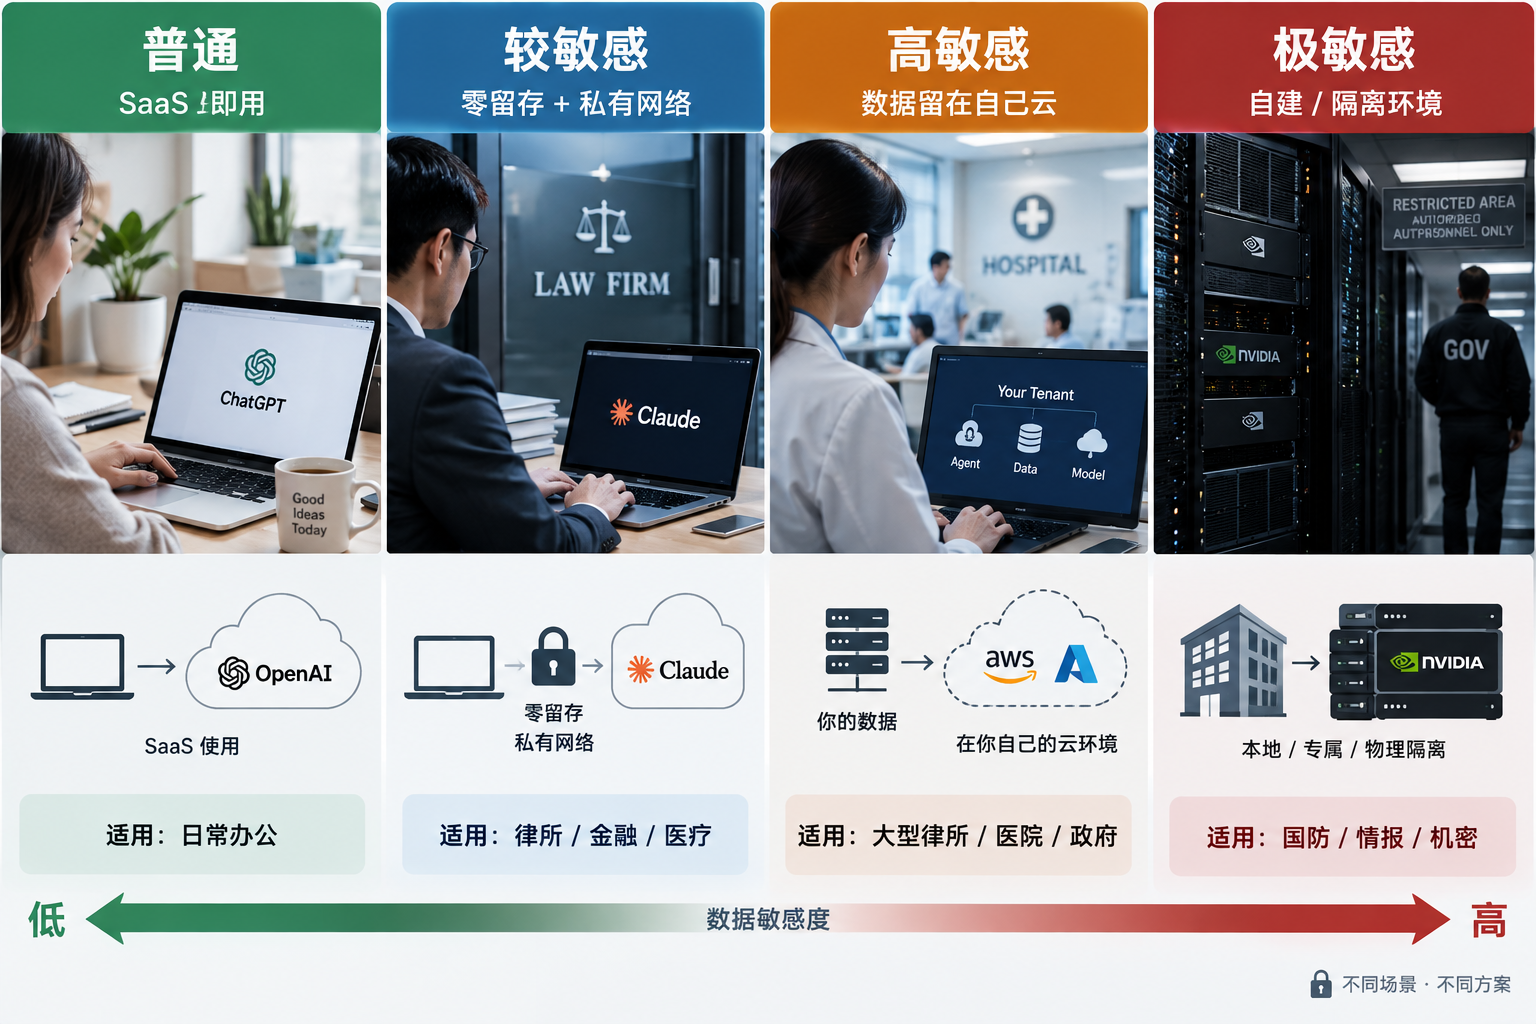
理想情况下,所有数据都可以在本地处理,不需要离开设备。哪怕云服务商提供合规审查和零数据留存保证,只要数据离开本地,就已经进入了新的信任边界,不能再按照本地处理的安全等级来对待。
因此,未来的重点可能会同时落在两个方向:更安全、高效的云端计算,以及足够高效的本地模型。
一个面向个人或小团队的本地 AI 示意组合可以是:
- 以 Google Gemma 4 作为基础模型;
- 使用 NVIDIA DGX Spark 作为小型 AI 工作站。
不过,这只是一个示意组合。真正的企业级部署还需要 IAM、网络隔离、审计、密钥管理、备份和终端安全。
结语
我这次真正观察到的,不是 Agent 一定会“偷”数据,而是:使用云端 Agent 后,文件的安全边界不再只在本地设备,而是扩展到了模型厂商、客户端、代理服务、插件和工具链。
Agent 越强,能够读取和操作的范围就越大;因此,权限最小化、数据分级和可验证的供应链透明度,也会变得越来越重要。
参考文献
Anthropic. (2026a, June 9). Claude Fable 5. https://www.anthropic.com/claude/fable
Anthropic. (2026b, September 10). Detecting and countering misuse of AI: September 2026. https://www.anthropic.com/threat-intelligence-report-september-2026
Ferstar. (2026, September 18). 某国产大模型厂商静默上传全量 Git 历史的调查 [Investigating a Chinese model provider’s silent upload of the full Git history]. Code is cheap, let’s talk. 原始报道
IT之家. (2026, September 18). 某国产大模型厂商被质疑“偷传代码”:官方回应称问题已修复,将开源代码库、引入第三方审查 [Chinese model provider accused of “stealing code”: Official response says the issue has been fixed and the codebase will be open-sourced]. IT之家. https://www.ithome.com/1/004/310.htm
PDFMathTranslate. (n.d.). PDFMathTranslate [Computer software]. GitHub. https://github.com/PDFMathTranslate/PDFMathTranslate
Reuters. (2026, September 14). Palantir, Nvidia curb AI model use over data fears, The Information reports. Yahoo Finance. https://finance.yahoo.com/technology/ai/articles/palantir-nvidia-curb-ai-model-151108619.html